0. 先交代一下背景
难得周日宅家闲来无事,总算不用去公司跟发版流水线和策划需求死磕对线 😋。白天泡了杯咖啡在自留地终端前敲代码,顺手翻社区技术群,看见不少搞 Web 出身的新手开始转行写专服,第一反应往往都是:“一个连接开一个协程,一个 RPC 再开一个协程,高并发多优雅!”
可只要你真上了生产服,200+ 玩家同屏,放几个 AOE 技能就能让服务器现场脑死亡——CPU 算力被线程调度、上下文切换和锁竞争全额挤干,客户端里的人物像喝了假酒一样走太空步漂移。Web 那套“每个请求开协程/线程”的并发哲学,到了游戏专服这,根本行不通。
今天彻底把这坨雷刨开,从商业专服一线实战的角度,把主循环(Game Loop)、Tick 驱动与单线程无锁架构给你掰碎聊透。
第一道门:思维休克——为什么 Web 微服务的并发哲学在游戏专服全线暴毙?
先对比一下两者的底层世界观差异:
| 维度 | Web 微服务(Stateless CRUD) | 强状态游戏专服(Dedicated Server) |
|---|---|---|
| 状态归属 | 服务端基本无状态,读写全下沉 DB/Redis | 服务端全内存权威,世界状态常驻堆栈 |
| 并发模型 | 线程池/协程池随便扩,各自独立处理 | 固定主循环单线程定序,靠 Tick 均匀推进 |
| 延迟容忍 | 200~500ms 几乎无感 | 超 33ms 客户端直接画面卡顿、动作断层 |
| 锁与调度 | 数据库事务锁、分布式锁、互斥锁随便上 | 核心主逻辑严禁互斥锁,纯靠时序裁决 |
Web 业务是无状态的单点 CRUD,协程卡顿或者锁冲突炸了无非接口超时重试。但游戏专服要几十上百名玩家在同一个大地图里同屏互砍,攻击前摇、位移判定、子弹碰撞、技能打断全极度依赖严苛的时序裁决。
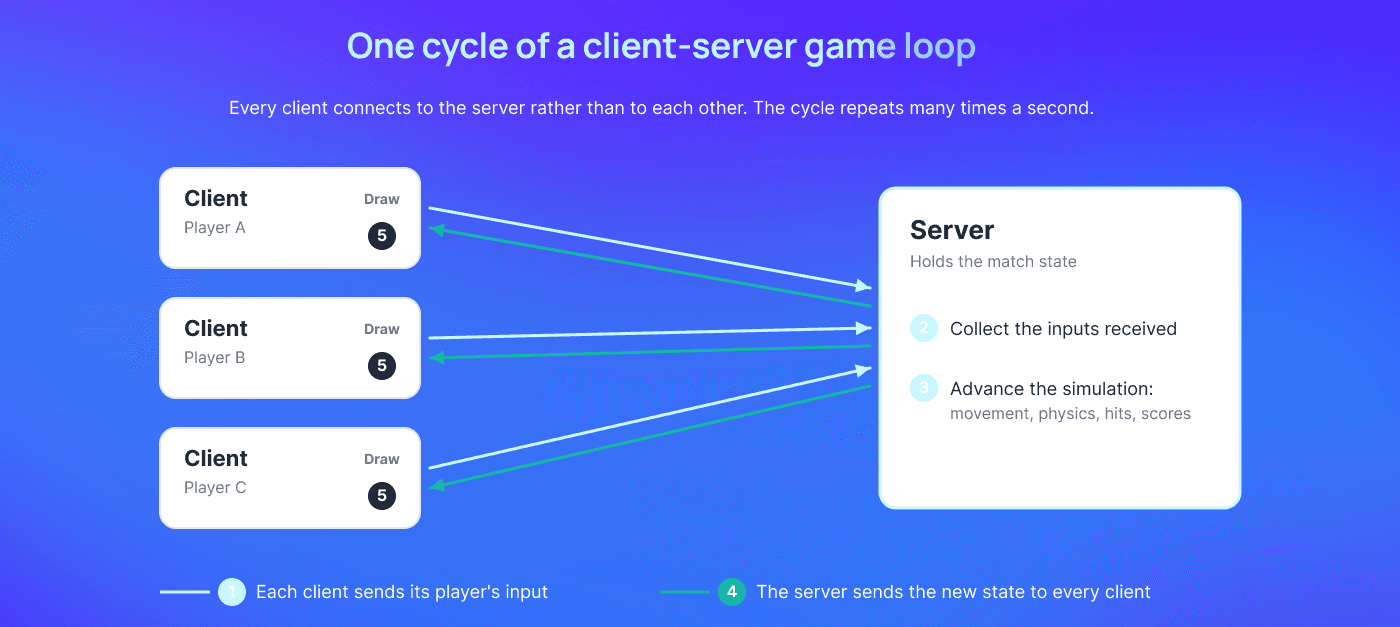
典型 Client-Server 架构下的 Game Loop:服务端汇聚所有客户端输入并推进世界模拟 · 图片来源:Client-Server Architecture in Games, Explained,版权归原作者。
如上图所示,在经典的 Client-Server 架构中,所有客户端本质上只是把自己的操作意图(Input)以封包形式上报给专服,服务端的单点 Game Loop 才是真正推进时钟的权威中心 [S2]。它统一收集所有输入、运行确定性物理和逻辑计算,再把计算出的世界权威状态快照(State Snapshot)广播给所有人 [S2]。
如果你按照 Web 思维让每个网络连接的协程去“并发改写”这份大世界内存状态,你就必须在玩家位置、怪物血量、背包列表上加满互斥锁。结果就是协程频繁挂起让出执行权,CPU Cache 命中率烂成碎渣,伴随着死锁和恶性竞态,服务端当场自挂东南枝。
> 💡 原则:游戏世界的所有交互都建立在空间和时序的强依赖之上。在专服内部,试图用多协程“并发”改写本地全局世界数据,就是性能与数据一致性的双重自杀。

第二道门:单线程胜过百核并发——解剖 Reactor + 纯内存无锁主循环
商业游戏服务端摸爬滚打十几年,行业沉淀下来的压舱石解法只有一个:网络 IO 线程分流,业务逻辑坚决单线程。用单线程的时序确定性彻底掐灭锁竞争。
那怎么充分榨干物理机几十个核心的网络吞吐?工业界标配架构就是 Reactor + MPSC 无锁队列:
flowchart LR
    subgraph NetLayer [网络 IO 线程池 Reactor]
        direction TB
        IO1["Socket IO 线程A (epoll/kqueue)"]
        IO2["Socket IO 线程B (epoll/kqueue)"]
    end
    subgraph Bridge [跨线程输入队列]
        RB["MPSC 无锁输入环形队列"]
    end
    subgraph Logic [专服主循环单线程 Loop]
        direction TB
        Drain["批量提取输入(Drain Batch)"]
        TickLogic["固定步长 Tick (AI/物理/判定)"]
        AOI["状态快照与 AOI 裁剪"]
        Out["无锁发送队列"]
        Drain --> TickLogic --> AOI --> Out
    end
    IO1 -->|非阻塞投递消息| RB
    IO2 -->|非阻塞投递消息| RB
    RB -->|主线程独占批量消费| Drain
    Out -->|网络回包| NetLayer
整个流水线的职责划分极其纯粹:
- 网络层(多线程 Reactor):专用 IO 线程做脏活累活。负责 Socket 监听、TCP/KCP 读写、心跳握手以及原始十六进制物理线序的完整性校验,解析成紧凑结构后立马脱手;
- 跨线程管道(MPSC 队列):所有网络线程把玩家输入事件 push 到单向无锁环形队列(MPSC RingBuffer)中。无 Mutex,无线程阻塞,各跑各的;
- 主逻辑线程(单线程 Game Loop):主循环单线程独占整个大世界数据!每个 Tick 启动时,第一件事就是批量 Drain 跨线程队列中的所有输入包。此时世界里的所有实体内存完全不需要一把锁,按确定性时序遍历更新。由于访问连续且集中,CPU L1/L2 Cache 几乎全部吃满 [S2];
- 网络出包(异步写出):Tick 逻辑算完后,生成的状态快照与 AOI 裁剪包直接丢进无锁发送队列,交由网络 IO 线程异步刷进网卡驱动。
在 1000 个动态实体的场景下,这种单线程纯内存逻辑往往 1~3ms 就能跑完一次 Tick。没有多线程调度与抢锁消耗,吞吐稳定如狗。

第三道门:时间黑洞——固定步长(Fixed Timestep)与致命的螺旋追帧
逻辑跑单线程了,那主循环怎么推进物理世界的时间?很多刚接触游戏开发的朋友非常喜欢写这种动态步长:
// ❌ 错误:动态步长
while (true) {
  double now = clock();
  double dt = now - last;
  last = now;
  update(dt);
}
这种写法把每次循环实际流逝的真实时间当成步长传给物理或位移逻辑,直接埋下巨大隐患。数值积分(显式欧拉法、Verlet 等)对时间步长 极其敏感 [S1]。
专服平时正常跑 30Hz(),一旦碰到一次底层磁盘 IO 阻塞或者 GC 停顿了 150ms,下一帧传进 update 的 dt 就会暴增到 150ms。这会导致子弹或快速移动的玩家瞬间穿透两米厚的障碍物碰撞体,弹簧与阻尼模拟甚至会直接数值溢出、发散到无穷大 [S1]。
业内标准解法:固定步长 + 时间累加器(Fixed Timestep with Accumulator) [S1][S2]。以专服逻辑 Tick 定死 30Hz 为例:
const double dt = 0.033333; // 30Hz 恒定逻辑步长
double acc = 0.0;
double last = hires_time_in_seconds();

while (running) {
  double now = hires_time_in_seconds();
  double frame_time = now - last;
  last = now;

  // 1. 安全截断:吸收时间设定硬上限,防止停顿过大导致追帧过载
  if (frame_time > 0.25) frame_time = 0.25; // [S1]
  acc += frame_time;

  // 2. 限制单帧最大补偿步数,斩断螺旋追帧死锁
  int max_steps = 4;
  int n = 0;
  while (acc >= dt && n < max_steps) {
    tick(dt);
    acc -= dt;
    n++;
  }

  // 3. 广播快照与客户端插值配合
  // 客户端依据残余 alpha = acc / dt,在前后两次快照间做 Lerp/Slerp 平滑渲染 [S1]
}
这套结构里有几个关键设计关乎生死:
- 步长恒定保证确定性:每次调用的
tick(dt)参数永远一致,逻辑运算结果完全可复现,无论是本地回放还是时序断言都不会发生漂移 [S1]; - 硬截断(Clamp)拦截历史:若机器发生系统级卡顿导致
frame_time暴增,坚决将其截断到 0.25 秒以内,宁可丢掉追不回的卡顿时间,也绝不去追远古历史 [S1]; - 步数安全阀防自杀:如果不限制单次循环补偿的步数(
max_steps),当单次 Tick 耗时本身超过步长时,服务器就会陷入臭名昭著的螺旋追帧死锁(Spiral of Death) [S1]。
flowchart TD
    Lag["突发 GC / 物理卡顿 frameTime 暴涨"] --> AddAcc["accumulator 极速积攒"]
    AddAcc --> LoopStart{"accumulator >= dt ?"}
    LoopStart -- 是 --> Tick["补跑一次 tick(dt)"]
    Tick --> Minus["accumulator -= dt"]
    Minus --> CheckT["补 tick 再次消耗真实时间 T"]
    CheckT --> AddAcc
    LoopStart -- 无限追帧、永不收敛 --> DeadLock["主循环彻底自杀 / CPU 100% 暴毙"]
    DeadLock -.->|安全阀拦截:单帧步骤上限或硬丢弃| Minus
在与客户端的协同呈现上,累加器中剩下的不足一步的时间零头 alpha = acc / dt 刚好作为状态插值的归一化权重 [S1]。客户端渲染管线利用这个 alpha 在上一个 Tick 状态与当前 Tick 状态之间进行线性插值(Lerp)或球面插值(Slerp),哪怕专服以 30Hz 推进,144Hz 的高刷显示器依然能渲染出顺滑流畅的画面 [S1]。

第四道门:毫秒级生杀大权——GC 顿挫、对象池与零堆分配军规
在 Java、Go 或 C# 编写的专服中,最容易将 30/60Hz 的生命线拖垮的,从来不是纯粹的算术逻辑,而是高频内存分配引爆的垃圾回收停顿(Stop-the-World)。主循环内随手 new 一个结构体,高并发下 1ms 的轻盈循环分分钟被拉长成 50ms 的黑洞。要保住稳定的帧预算,必须将零堆分配刻进肌肉记忆:
- 军规 1:主循环 Tick 核心路径严禁堆内存 new 高频执行的热点路径,只允许使用栈内存、结构体值传递或启动期预分配的连续内存。在 Tick 内部动态 new 短命对象,发版上线后掉的一定是自己的头发;
- 军规 2:对象池归还必须强校验 reset,严防僵尸指针 对象用完回收进池子前,必须执行彻底的字段擦除与指针置空。否则幽灵实体的脏引用被复用给其他会话,就会制造一整天毫无规律的玄学串数据 Bug;
- 军规 3:快照与历史环形缓冲区全走定长数组 做状态同步、延迟补偿与历史快照回溯时,严禁使用会动态扩容的切片或链表,必须用定长 RingBuffer。游戏后端的底色就是定时、定长与定序;
- 军规 4:原始字节切片直接偏移读取,慎用重反射结构体 高频网络封包直接按固定偏移量解码,主线程直接读取紧凑二进制字段,杜绝拆装箱与反射带来的临时内存驻留。
💡 方法论总结
> 1. 主循环权威,时序胜过并发。将网络 IO 与世界状态彻底解耦,用 MPSC 无锁队列将网卡事件串行化,主线程独占全内存定序推进,把 CPU 缓存性能压榨到极致 [S2]。 > 2. 固定步长与安全截断。摒弃脆弱的动态步长,通过时间累加器驱动逻辑;务必给累加时间与最大补偿步数装上安全阀,斩断螺旋追帧死锁 [S1][S2]。 > 3. 降级高于完美,永远贯彻 fail-open。机器卡顿导致追帧滞后时,主动丢弃超时步数也绝不陷入死循环,线上服务的存活性永远是第一原则。 > 4. 零堆分配消灭 GC 停顿。对象池定长复用,把不可控的突发内存开销按死在启动加载阶段,给每一次稳定的 Tick 留出从容的耗时预算。
把主循环的时序基底和单线程无锁架构打扎实了,业务开发才能踏踏实实往下写。少踩两个时序死锁的坑,晚上才能安心回自留地折腾自己喜欢的小玩具 😋。
参考资料
- [S1] Glenn Fiedler. Fix Your Timestep! [S1]
- [S2] Bob Nystrom. Game Programming Patterns: Game Loop [S2]
参考资料
- [S1] https://gafferongames.com/post/fix_your_timestep/(读取于 2026-10-24)
- [S2] https://gameprogrammingpatterns.com/game-loop.html(读取于 2026-10-24)
评论 (0)